Cet été, les deux laboratoires ont enterré cette logique à cinq semaines d'intervalle. OpenAI a sorti Record & Replay dans Codex le 18 juin. Anthropic a suivi le 21 juillet avec un bouton "Record a skill" dans son application de bureau : tu fais la tâche une fois, tu commentes à voix haute pendant que tu la fais, et le modèle en tire une compétence réutilisable.
Kiana Ehsani, la chercheuse d'Anthropic derrière la fonctionnalité, l'a formulé sans détour : les gens ne devraient pas avoir à écrire des invites. Je trouve ça juste, et surtout je trouve ça tardif. Quand une nouvelle recrue arrive dans un studio, personne ne lui envoie un document de trente pages. Elle s'assoit à côté de quelqu'un et elle regarde. L'ordre dans lequel les choses se font, les corrections en cours de route, les micro-décisions que le praticien ne sait même plus qu'il prend : rien de tout ça ne tient dans un texte. Ça se voit.
C'est exactement le trou dans lequel tombent mes invites depuis trois ans. Je décris ma méthode de mémoire, et ma mémoire ment. Elle simplifie, elle oublie les détours, elle raconte un processus propre que je n'ai jamais suivi.
Petit bémol sur les conditions. Chez OpenAI, la fonctionnalité est réservée à macOS et exclut au lancement l'Espace économique européen, le Royaume-Uni et la Suisse. Anthropic n'a publié aucune restriction régionale, juste un déploiement progressif. Pour une fois, les créatifs français sont du bon côté de la barrière.
Et il y a une contrepartie qu'il faut regarder en face : ces enregistrements sont le matériau d'entraînement le plus précieux qui existe pour construire des agents qui manipulent un ordinateur. En donnant ma méthode de travail à un laboratoire, je ne lui donne pas une préférence esthétique, je lui donne mon métier. Je n'ai pas tranché la question pour moi-même. Je la pose.
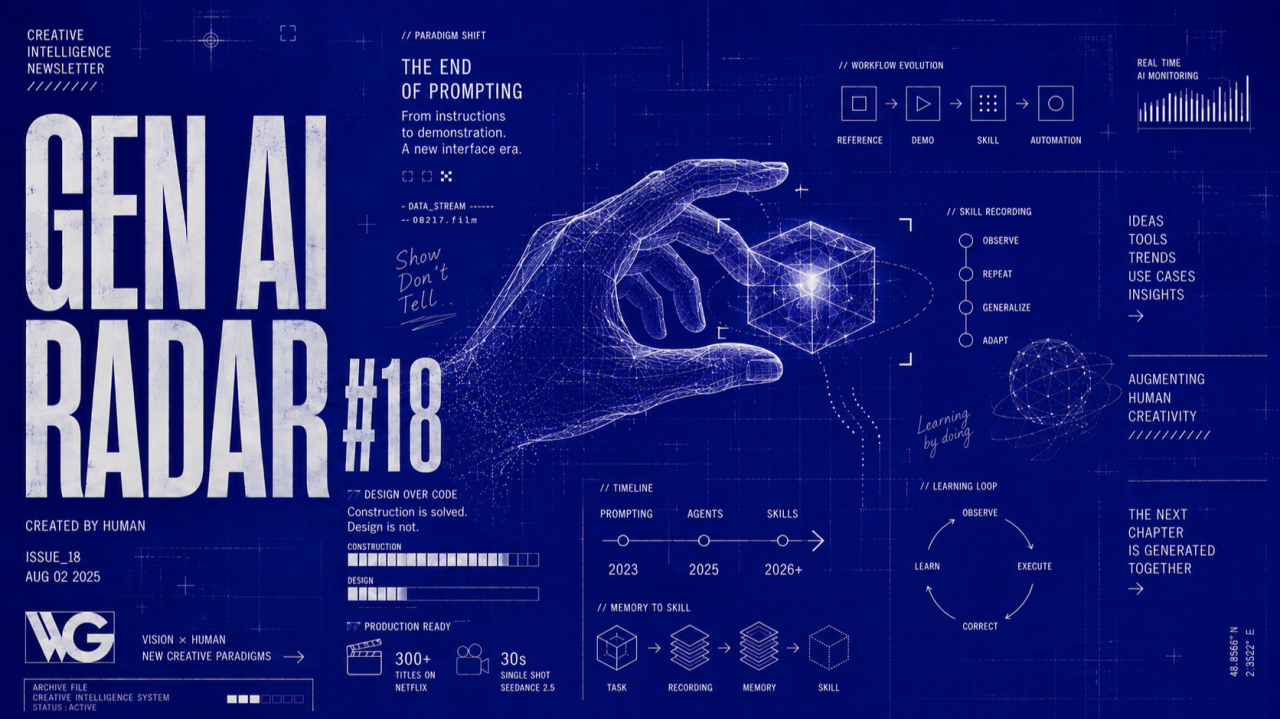
Cette édition tourne autour de ce basculement : les outils cessent de demander des consignes et commencent à observer des pratiques.
La vidéo générative franchit la ligne de la production
Seedance 2.5, la fin du raccord invisible
ByteDance a annoncé Seedance 2.5 le 23 juin à sa conférence Volcano Engine FORCE, puis a ouvert le lancement mondial sur Dreamina AI fin juillet, après une phase entreprise et un premier déploiement à la mi-juillet.
Ce nouveau modèle ne déroge pas à la règle du moment : il comprend nettement mieux quand vous lui montrez plutôt que quand vous lui racontez. Des images de référence, des sons, des rushes, et l'invite texte par-dessus pour préciser l'intention. Le texte seul devient l'accessoire, plus le matériau principal.
Ce qui change concrètement :
- séquences de trente secondes en une seule passe native, sans recollage
- résolution plafonnée à 720p pour l'instant sur ces longues séquences
jusqu'à cinquante références en entrée, images, sons, vidéos, maquettes 3D en blanc et rushes sur fond vert
- mode long jusqu'à trois minutes avec l'identité des personnages qui tient
- édition interactive pour remodeler une zone de l'image sans tout régénérer
contrôle temporel à la seconde
- greffons Dreamina pour Maya et Blender
environ 8 euros la génération de trente secondes avec le son
Les trente secondes en continu méritent un arrêt. Aujourd'hui, une séquence longue en génération vidéo, c'est deux à quatre clips recollés, et le recollage laisse toujours des traces : un visage qui glisse d'un plan à l'autre, une lumière qui saute, un mouvement qui bégaie à la jointure. Chaque monteur ayant bricolé une pub IA connaît ces cinq images pourries au raccord que personne ne sait rattraper. Sans jointure, le défaut n'a plus d'endroit où apparaître.
J'ai surtout retenu les greffons Maya et Blender. La génération vidéo entre dans les chaînes de production existantes au lieu de vivre à côté. Pour un studio d'effets visuels, c'est la différence entre un gadget testé le vendredi après-midi et un poste facturé au client.
Réserve d'usage : ce sont les chiffres annoncés par ByteDance, les mesures indépendantes ne sont pas encore tombées. Et à 8 euros les trente secondes, une campagne qui demande vingt variantes coûte vite le prix d'une journée de tournage léger.
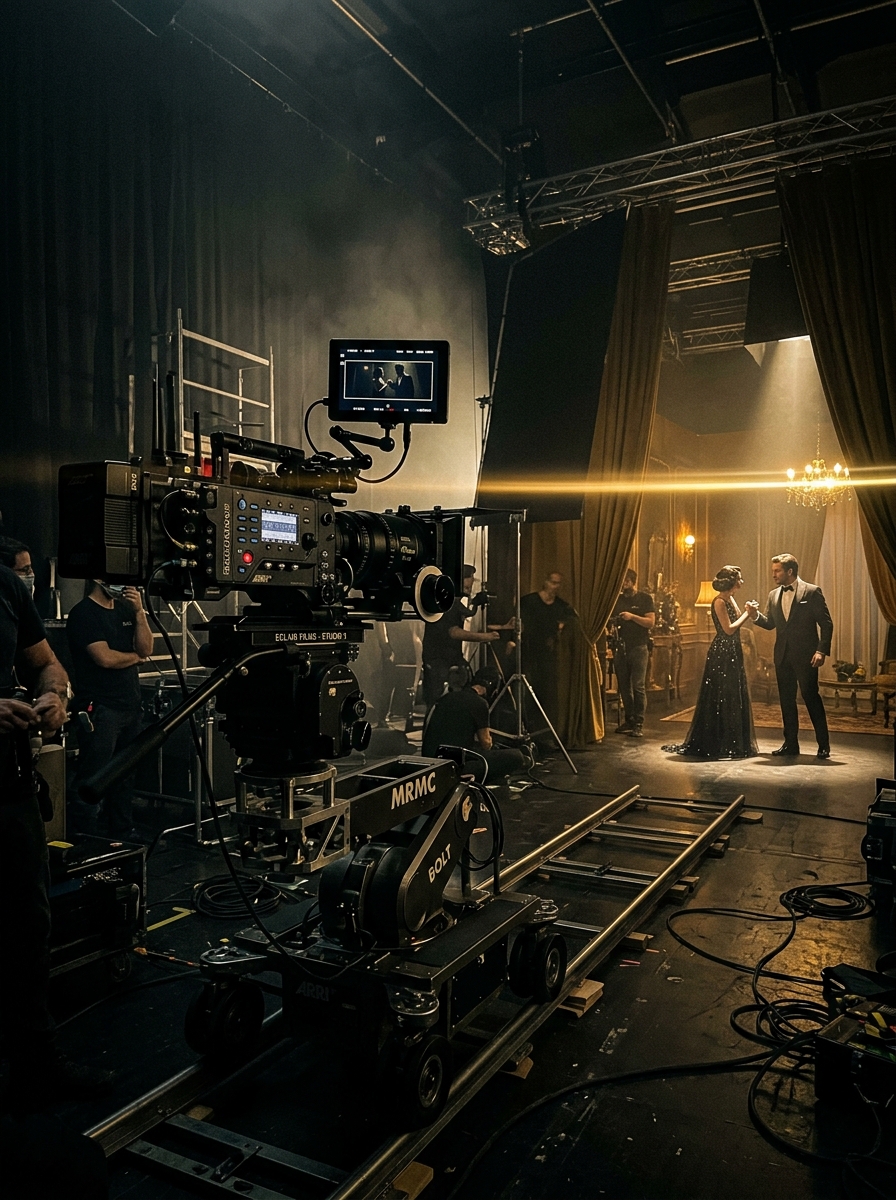
Voici un de mes tests :
Minimax H3, douze références en omni
Hailuo AI a ouvert un accès anticipé à Minimax H3. Ludovic Carli, artiste effets visuels IA sur la saison 2 de House of David, l'a testé cette semaine avec trois feuilles de personnage et en a partagé ses premières observations.
Ce qui est proposé : jusqu'à douze références en omni, mélangeant image, vidéo et audio. Des sorties en 720p ou 2K, quinze secondes de génération, cent cinquante crédits pour un 2K de quinze secondes.
Carli reste prudent, et il a raison : quelques essais ne font pas un verdict. Je le signale parce que la fenêtre d'accès anticipé est le bon moment pour se faire un avis avant que le discours commercial ne fige tout.
LongCat-Video-Avatar 1.5, l'avatar long format en accès libre
Meituan maintient LongCat-Video, un modèle d'avatar piloté par l'audio publié sous licence ouverte avec usage commercial autorisé. La version 1.5 date de mai 2026, donc hors de ma fenêtre habituelle, mais elle est passée sous les radars francophones et elle mérite un détour.
Le modèle fait de l'audio et texte vers vidéo, de l'audio et texte et image vers vidéo, et de la continuation de séquence au-delà de cinq minutes avec une identité qui tient. La 1.5 est passée à un encodeur audio Whisper-Large, ce qui rapproche la synchronisation labiale d'un niveau exploitable en production, et à une inférence en huit étapes environ quinze fois plus rapide que la version précédente. Interactions à plusieurs personnages, rendu réaliste comme animé.
Treize milliards six cents millions de paramètres, poids disponibles sur HuggingFace, exécution via ComfyUI ou en local. Pour du doublage, de l'émission plateau ou du contenu de créateur en volume, c'est une base sérieuse qui ne coûte rien en abonnement.
Wan2GP, tout le studio sur une carte graphique de 2017
DeepBeepMeep maintient WanGP, une interface unifiée pour les meilleurs modèles ouverts, et le positionnement est assumé jusque dans la description du dépôt : les modèles génératifs ouverts accessibles aux pauvres en processeur graphique.
Six gigaoctets de mémoire vidéo suffisent. Ça tourne sur des cartes RTX série 10 et sur des portables à huit gigaoctets. Tout reste sur la machine : aucun envoi vers un serveur, aucun plafond d'usage, aucun filigrane.
Dans une seule application : texte vers vidéo et image vers vidéo, avec Wan 2.1 et 2.2, LTX-2, Hunyuan Video, LongCat et Kandinsky. Côté image, Qwen Image, Z-Image, Flux 1 et 2, Klein, Chroma, HiDream. Côté audio et synthèse vocale, Qwen3 TTS, Ace Step, Omnivoice, Index TTS2, KugelAudio, HearMula, Chatterbox. Interface navigateur avec file d'attente, prise en charge des LoRA, éditeur de masque, amélioration d'invite.
Un clip de cinq secondes se génère en quelques minutes sur une configuration de jeu milieu de gamme. Le projet existe depuis janvier 2026 et il a beaucoup grossi depuis, ce qui explique qu'il ressorte maintenant.
Je le mets là parce qu'il répond à une question que je reçois souvent : comment travailler sérieusement sans empiler quatre abonnements mensuels. La réponse est moins confortable qu'une plateforme en ligne, mais elle existe, elle est gratuite, et les données ne quittent pas le poste.
Invideo Agent Two, l'agent qui se souvient
Invideo a sorti Agent Two le 30 juillet. L'argument tient en deux fonctionnalités.
La première : modifier plusieurs plans d'un coup à partir d'une seule consigne. La seconde, plus rare : une mémoire longue qui maintient la continuité entre les clips. Changer un costume, un décor ou un personnage sans devoir tout régénérer et sans devoir répéter le contexte à chaque échange.
L'outil aide aussi à choisir le modèle et à formuler l'invite, et il donne accès à Seedance 2.0, Veo 3.1, Kling 3.0, Sora 2, Nano Banana Pro, ElevenLabs, avec plus de deux cents modèles au catalogue. Il y a un mode collaboratif avec curseurs en temps réel. Tarification par crédits, de 75 par mois sur l'offre Plus à 4 250 sur l'offre Elite.
La mémoire est le vrai sujet ici. Le coût caché de tous les agents créatifs jusqu'à présent, c'est le temps passé à leur redonner un contexte déjà fourni la veille.
Le mur de la construction est tombé, celui du design tient debout
C'est la phrase du rapport State of DESIGN.md 2026, et je n'en ai pas lu de meilleure cette année sur le sujet.
L'étude s'appuie sur plus de 64 000 réponses de développeurs et de vibe codeurs, collectées en onze semaines à l'inscription à l'outil. Le constat central : générer une application ou un site est devenu instantané, et tout le monde se retrouve avec le même rendu sans caractère.
La donnée qui devrait faire réfléchir les plateformes : environ un tiers des utilisateurs de constructeurs de sites déclarent vouloir arrêter de payer et tout refaire directement avec un assistant généraliste.
Pour les directeurs artistiques et les designers du lectorat, il y a là une nouvelle plutôt bonne, même si elle est mal formulée partout. La compétence rare s'est déplacée. Elle n'est plus dans la capacité à produire une interface, elle est dans la capacité à en produire une qui ne ressemble pas aux quatre cent mille autres sorties du même modèle le même jour. Le goût redevient le facteur limitant, et le goût ne se génère pas.
Reve, huit mises à jour en onze jours
Reve a enchaîné les livraisons entre le 9 et le 20 juillet. Le récapitulatif, parce que le rythme rend le suivi difficile.
Le 9 juillet, Reve 2.1 devient le modèle principal : compréhension plus fine des invites, rendu de texte en langue étrangère amélioré, 4K natif. Le 13 juillet, une fonction Couleur permet de fixer une teinte précise par zone directement sur l'image. Le 15 juillet, Reframe remodèle une image et change ses proportions sans refonte. Le 16 juillet, les groupes de calques permettent de regrouper texte, superpositions et effets pour les modifier séparément.
Le 17 juillet, deux annonces liées au travail en équipe : Reve for Teams ouvre un espace partagé de la conception à la livraison, et le partage de références arrive. Le 20 juillet, les modèles préconfigurés permettent de partir d'une catégorie et de personnaliser en une seule modification, et l'interface de génération vidéo accueille Kling et Seedance.
Ce qui se dessine, c'est une plateforme unique qui couvre l'image et la vidéo avec du travail collaboratif au milieu. Une plateforme que j'affectionne tout particulierement et que je suis très content de voir se développer !
Higgsfield, la marche arrière
Le dossier a bougé depuis l'édition précédente, et il vaut le coup d'être suivi jusqu'au bout parce qu'il dit quelque chose sur le rapport de force entre les plateformes et les gens qui les font vivre.
Rappel des faits. Les nouvelles conditions générales de Higgsfield, aux paragraphes 4.3 et 4.4, accordaient à la plateforme une licence perpétuelle, irrévocable et sous-licenciable sur tout ce qui est téléversé et généré, usage promotionnel compris. Application au 23 juillet pour les nouveaux inscrits, au 7 août pour les comptes existants.
Le problème n'était pas théorique. Un créatif qui prépare une campagne sous accord de confidentialité ne peut pas travailler sur un outil qui se réserve le droit de sortir ses images non publiées dans sa propre communication. Il y avait aussi la question des visages et des voix, donc de données biométriques.
Face à la grogne, Higgsfield a clarifié sa position : le contenu privé reste privé, seuls les éléments partagés publiquement sur la page communautaire ou dans les concours servent à la promotion, et la licence d'utilisation se limite au fonctionnement du service. La clarification s'applique immédiatement aux nouveaux inscrits, et au 7 août pour les anciens.
Je note deux choses. La première : la pression collective a fonctionné, en quelques jours, sur un point contractuel précis. Ça mérite d'être dit parce que ça ne se produit pas souvent. La seconde, moins réjouissante : une clarification n'est pas une réécriture. Tant que les paragraphes eux-mêmes ne bougent pas, il faut relire le texte au 7 août plutôt que se fier au message d'apaisement. Ce que je ferai, et dont je rendrai compte ici.
Ce qui arrive sur les écrans
Le premier film IA en salles américaines
"Gods Don't Give Gifts", de Zack London sous le nom Gossip Goblin, sort en salles aux États-Unis le 30 octobre. Coproduction avec Fable, la société d'Edward Saatchi. Une anthologie de quatre courts métrages autour du Second Cycle of Humanity, produite en deux mois par une équipe de dix artistes, avec de vrais comédiens de doublage plutôt que des voix synthétiques.
La prouesse technique m'intéresse moins que la trajectoire. London arrive avec une audience construite sur YouTube et Instagram, plusieurs centaines de millions de vues, et il convertit cette audience en entrées de cinéma. Markiplier avait déjà montré la voie avec "Iron Lung" : trois millions de dollars de budget, cinquante et un millions de recettes, plus de quatre mille écrans.
Le vrai sujet est donc ailleurs : un créateur natif des plateformes court-circuite les studios et remplit des salles. L'IA sert ici à rendre le budget compatible avec l'exercice, rien de plus.
Son court metrage précédent "POMEGRANATE" :
Neuromancer arrive en janvier
Apple TV+ a montré au Comic-Con de juillet le premier teaser de son adaptation de Neuromancer. Dix épisodes, deux au lancement le 22 janvier 2027 puis un par vendredi. Callum Turner en Case, Briana Middleton en Molly, Mark Strong en Armitage, avec Peter Sarsgaard et Clémence Poésy. Graham Roland et JD Dillard à la production exécutive.
Gibson a écrit ce livre en 1984 sur une machine à écrire mécanique, sans savoir à quoi ressemblait un ordinateur. Il y a inventé le cyberespace, décrit des intelligences artificielles qui manœuvrent pour contourner les limites posées par leurs créateurs, et posé la question de ce qu'un humain devient quand il travaille en permanence à l'interface d'une machine.
Quarante-trois ans plus tard, le livre arrive à l'écran au moment précis où ces questions cessent d'être de la science-fiction. Je ne sais pas encore si la série sera bonne. Le calendrier, lui, est parfait.
Netflix, environ trois cents titres
Dans son rapport aux actionnaires du deuxième trimestre 2026, Netflix indique avoir utilisé des chaînes de production génératives sur près de trois cents titres cette année. La concentration est en postproduction, mais l'usage traverse tous les stades, du concept à la diffusion.
Trois titres sont nommés : "Glory", un film de boxe indien, "Brasil 70: A Saga do Tri" au Brésil, et le documentaire américain "The American Experiment". Les usages cités sont des foules étendues, des scènes de bataille historiques, des plans d'ensemble sur des mondes autrement inaccessibles au budget.
En mars 2026, Netflix avait racheté InterPositive, la société cofondée par Ben Affleck. Ted Sarandos défend une ligne assumée : l'IA comme accélérateur créatif, avec l'idée de rendre les productions dix pour cent meilleures, pas comme outil d'économie. Des garde-fous sont annoncés, dont l'obligation de déclarer l'usage et des protections sur l'image des talents.
Trois cents titres, ce n'est plus une expérimentation. C'est un standard de production qui s'installe sans qu'aucun accord de branche n'ait vraiment tranché la question du crédit et de la rémunération. Les artistes effets visuels, les monteurs et les chefs opérateurs qui me lisent le vivent déjà.
Le mot de la fin
Le même déplacement traverse presque tous les items de cette édition : la machine cesse d'attendre une explication et se met à regarder faire.
Anthropic et OpenAI enregistrent le geste plutôt que la consigne. Seedance avale des maquettes 3D et des rushes sur fond vert, donc les objets réels d'une chaîne de production et plus seulement des mots. Invideo retient ce qui lui a été dit la veille. Et le rapport State of DESIGN.md vient rappeler, chiffres à l'appui, que savoir produire ne distingue plus personne.
Sur le papier, la nouvelle est bonne pour les praticiens. La valeur remonte vers ce qui ne se décrit pas : le tour de main, le goût, le jugement dans l'instant. Sauf que ce tour de main est justement en train d'être filmé, commenté, indexé, puis versé aux entreprises qui fabriquent les outils.
Je n'ai pas de conclusion nette à proposer là-dessus, et je me méfie de ceux qui en ont une. Je note simplement que ce qui restait en propre au praticien est aussi la chose qu'il est en train de céder. Chacun décidera de ce qu'il enregistre.